





卡尔曼滤波:温度读数在抖,怎么滤才靠谱?

给板子接上一颗温度传感器,串口里不断刷出 25.02、24.97、25.05、25.01 ℃。房间里没什么变化,读数却一直跳。加一个滑动平均,显示安静了;拿手指靠近探头,温度开始上升,滤波后的数字又迟迟跟不上。
窗口再缩小一点,跟得快了,噪声又回来了。
这时可以换一种问法:上一秒估计探头是多少度?一秒内温度大概能变多少?新读数和原来的估计差了一截,是温度真的变了,还是测量噪声?
卡尔曼滤波处理的就是这件事。它既保存一个状态估计,也保存这份估计有多不确定。新数据到了,拿两者一起算;没有新数据,就先沿着模型往前推。
下面先用温度读数手算一次更新,再写一个 MCU 上能用的标量滤波器。后半篇换成 IMU:陀螺仪负责跟踪转动,加速度计提供倾角参考,同时估计陀螺仪零偏。文中的四张中文曲线图由仿真生成;MIT 讲义和 ADI 应用笔记的十张配图来自原资料裁切,图下注明了位置。
先说清楚温度例子估计的是什么:这里估计的是探头自身的温度。探头升温需要时间,滤掉电噪声不能顺便消除热惯性。若要估计空气温度,必须另外考虑探头与空气之间的传热,不能把滞后全算到滤波器头上。
1. 应用范围与传感器测量问题
1.1 先分清:滤波器估计什么
如果只想让一个变化很慢的温度或电压读数平稳一点,一阶低通通常就够用。卡尔曼滤波值得用的地方,是你还掌握了一些状态变化规律,或者有多个来源各有短处的测量。
温度例子里,状态是探头温度,观测是传感器换算出的温度读数。到了 IMU 例子,状态会变成倾角和陀螺仪零偏;加速度计提供倾角观测,陀螺仪读数则进入预测。
MIT 的讲义先介绍状态观测器。注意下面框图的反馈箭头:实际输出和模型输出的差,送回的是模型。它在修正估计,并没有直接给电机下命令。这和上一篇 PID 里调节被控对象的反馈回路,作用位置不同。[1]
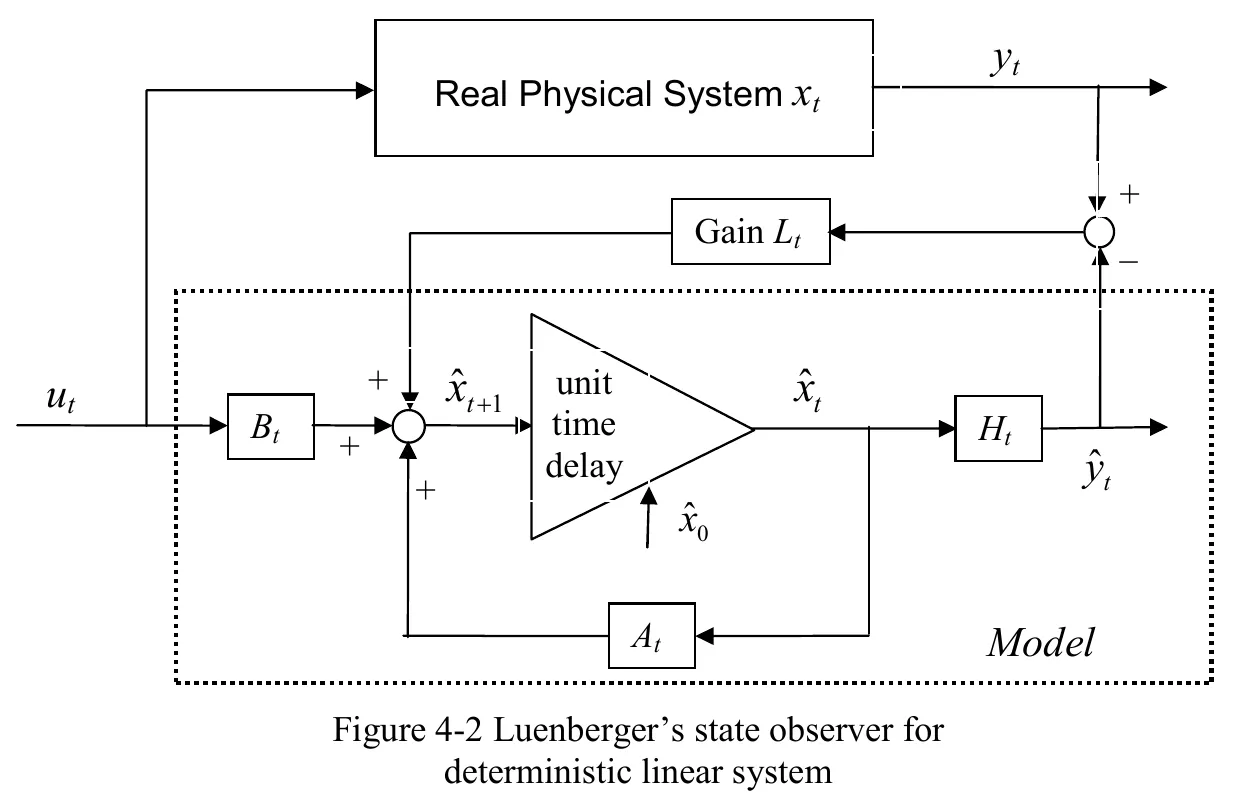
原图裁切:MIT 2.160,Lecture 5,第 2 页,Figure 4-2。原讲义用 A 表示状态转移矩阵,本文后面用 F;两者是同一类量。[1]
带噪声以后,不能每次都把模型硬拉到测量值上。我们需要知道,差异有多大是正常的,哪一边更可能出错。
2. 状态、噪声与协方差基础
温度读数本身不是“状态”。滤波器要估计的是探头此刻的温度状态;传感器的输出只是带噪声的观测。模型对下一时刻的推断也可能不准。卡尔曼滤波把这两种不确定性都用协方差表示,而不是只对串口数据做平滑。
2.1 先验、观测与误差方差
后文的 表示看到本轮传感器读数前的预测, 是用读数校正后的估计; 是对应估计误差的方差。 表示模型在一个采样间隔内遗漏的变化, 表示测量噪声。它们都要使用方差,单位是状态单位的平方。
3. 预测与更新:温度读数的手算实例
假设根据之前的数据,我们预测探头现在是 25 ℃,预测误差的方差是 0.04 ℃²。新读数为 26 ℃,测量噪声方差是 0.01 ℃²。数字故意选得整齐,方便手算;这不是某款传感器的实测指标。
方差不是标准差。这里预测的标准差是 0.2 ℃,测量的标准差是 0.1 ℃。只看这两个数,测量相对更可靠,但预测也不是完全没用。
记预测为 ,预测误差方差为 ,测量为 ,测量噪声方差为 。对于直接测量同一个标量、测量噪声与预测误差不相关的情况,增益是:
用它修正预测:
这相当于保留 20% 的预测,再加上 80% 的测量。融合后的方差是:
在这组假设下,融合比单独使用任何一方都更确定。这个结果依赖两边误差没有重复计算;如果两个输入其实来自同一个传感器,不能装作它们互不相关,再“融合”出虚假的高精度。
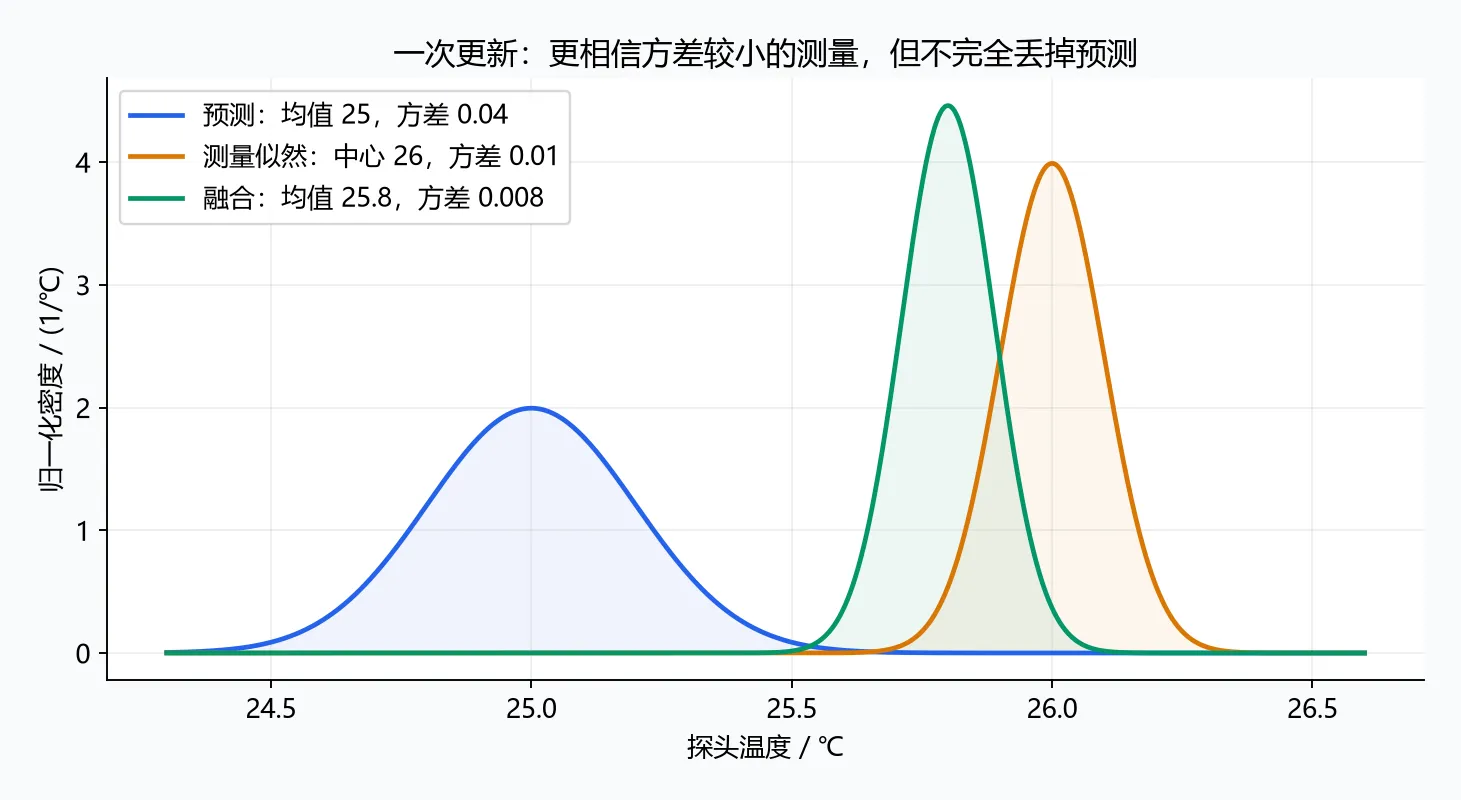
本文仿真。蓝色是预测分布,橙色是把测量似然按温度归一化后的曲线,绿色是后验分布。这里假设误差为高斯分布;并不是先知道了真实温度,再画一条更好看的曲线。手算只演示融合权重,这个偏离预测较大的读数是否应被接受,后面还会讲。
为什么不是两个数直接平均?因为直接平均默认双方误差方差相同。把 换成 0.04,增益恰好就是 0.5。
还有个容易混淆的地方: 是滤波器依据模型和参数维护的误差协方差,不是拿真实温度减出来的实时误差。真实温度往往根本不知道。参数设得过于乐观, 可以很小,实际误差却很大。
3.1 一直算下去,需要“预测”这一步
上面的更新只处理了某一时刻。到了下一秒,探头可能又升温了一点,上一刻的估计不再有同样的把握。
先从最简单的标量随机游走模型开始:
这里 是探头温度, 表示两次采样间模型没解释的温度变化,方差记为 ; 是测量噪声,方差为 。先按零均值、各时刻不相关、两类噪声互不相关来建模。这是一个简化起点,没有描述探头的具体传热过程。[1][3]
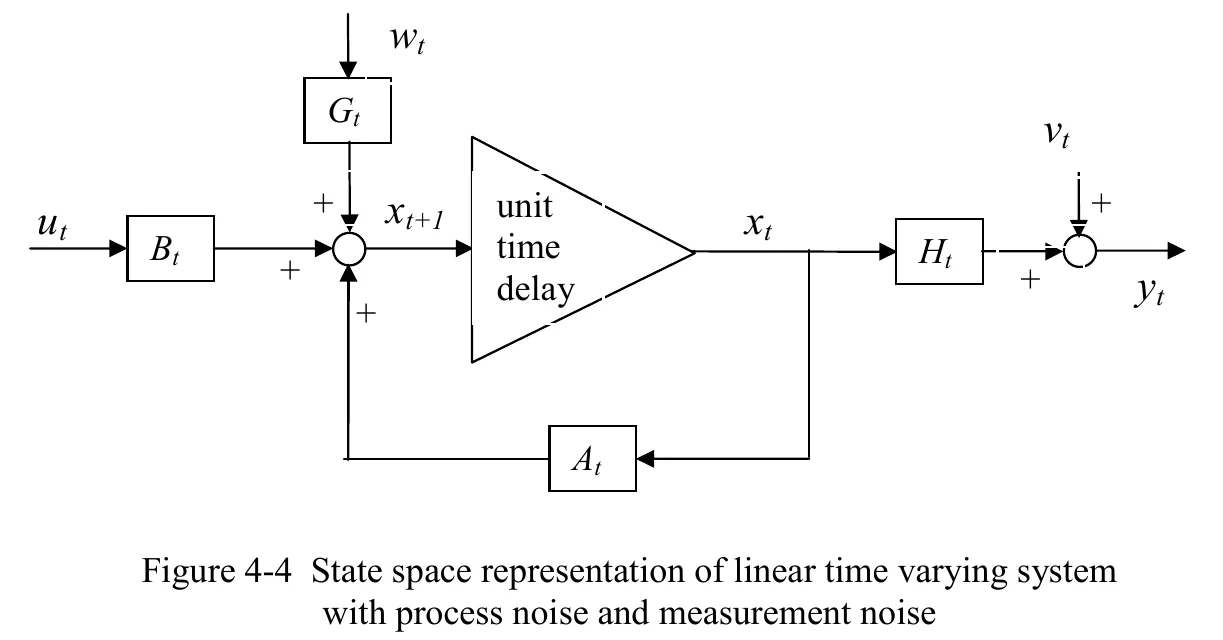
原图裁切:MIT Lecture 5,第 5 页,Figure 4-4。w 进入状态演化,v 加在观测端。这两种误差的入口不同,不应把 Q、R 都解释成“传感器有多抖”。[1]
对于这个随机游走模型,预测很简单:
预测的温度没变,但不确定性增加了。更新则重复刚才的手算:
循环里只需要保留上一轮的估计和方差,不用保存全部历史读数。这就是“递推”。
如果本轮传感器超时,做预测,跳过更新即可。不要用上一次读数假装一条新测量,否则滤波器会重复相信同一份信息,让方差不合理地缩小。
4. 温度滤波实现与 Q/R 选择
4.1 Q、R 到底怎么选
比较容易起步。把传感器放在稳定条件下,固定采样率和量程,记录一段数据,计算样本方差:
这估计的是该条件下读数的离散程度。测温时应先让探头与环境充分稳定,避免把真实升温算成测量噪声。固定偏差不会因为减去均值就自动消失;自热、供电变化和连续样本相关性也需要另查。传感器自带平均滤波时,相邻输出尤其不一定独立。
要跟着模型选。在刚才的随机游走模型里,它描述每步温度变化的方差,不是传感器数据手册里精度指标的平方。
先看一段模拟的探头温度:开始保持 25 ℃,60 秒后逐渐升温,120 秒后叠加一段缓慢上升。测量噪声标准差固定为 0.1 ℃,三条估计使用完全相同的测量、初值和 ,只改 。升温用了平滑的指数过渡,不让真实探头瞬间跳温。
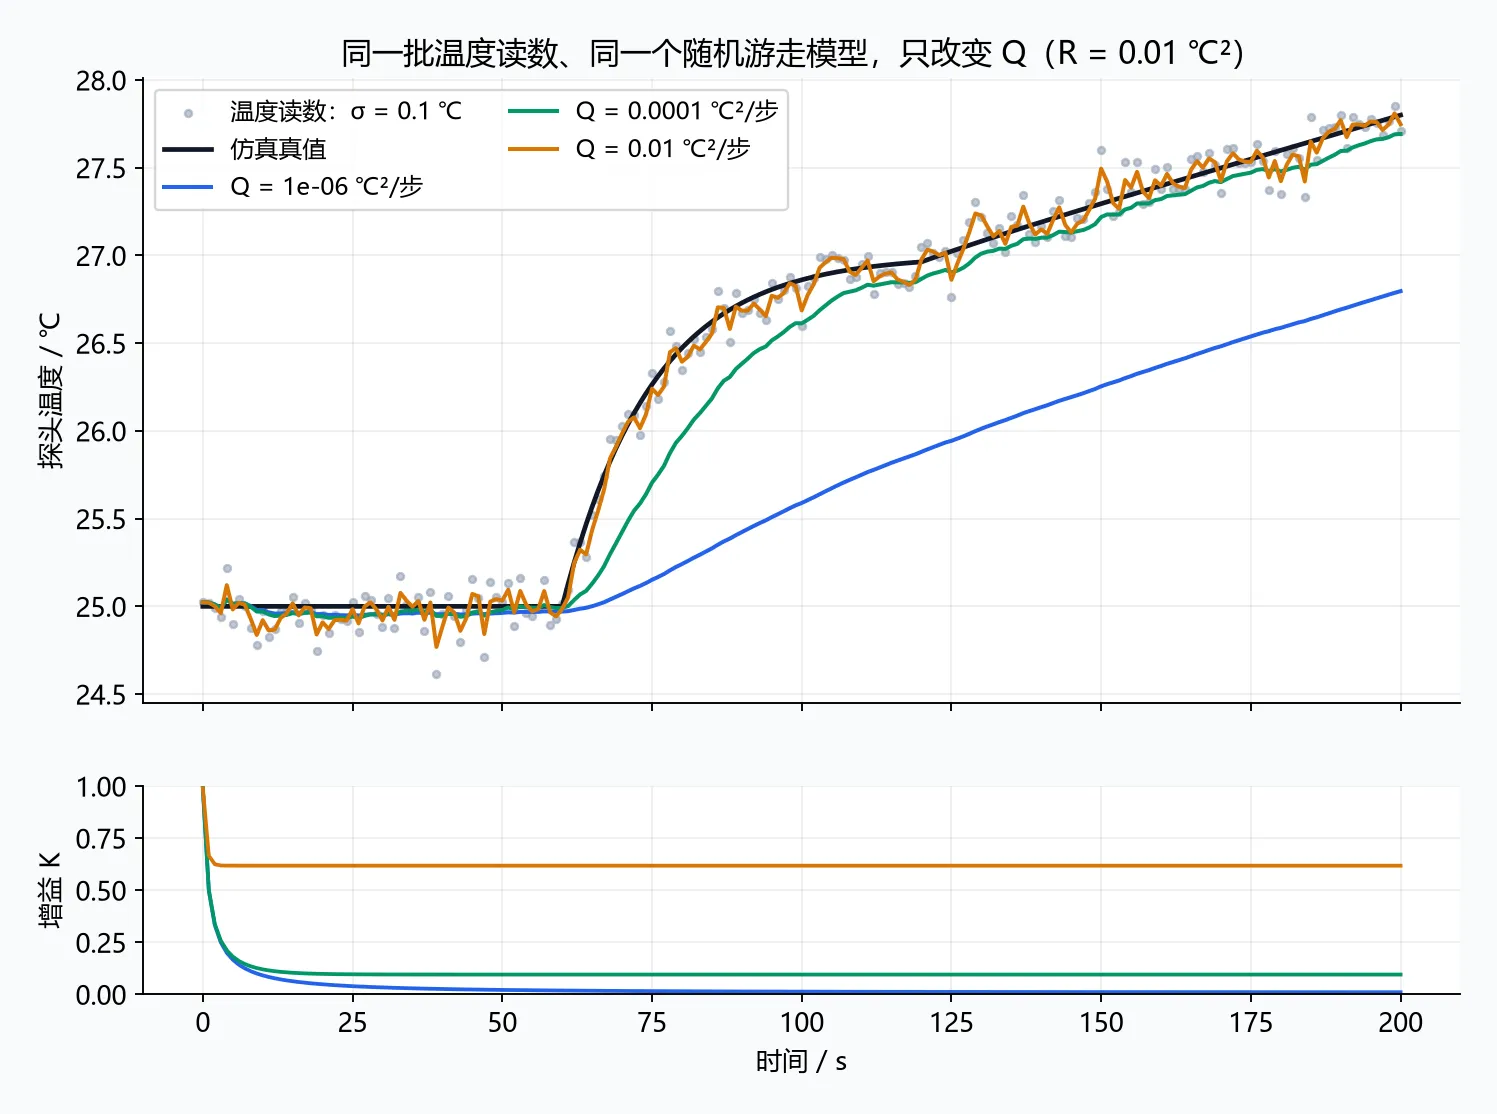
本文仿真。采样间隔 1 s,R = 0.01 ℃²,初始估计 25 ℃、P = 1 ℃²;Q 分别为 0.000001、0.0001、0.01 ℃²/步,随机种子 1606。60 s 起的升温为 2[1−exp(−(t−60)/15)] ℃,120 s 起另加 0.01(t−120) ℃。这段确定性温度曲线用于比较跟踪滞后,不代表某款探头的实测响应,也不符合零均值随机游走的全部假设。
小,滤波器觉得温度每秒不会变太多,曲线平稳,碰到升温却不愿及时跟上。 大,预测没那么值得相信,测量对结果的影响更明显,噪声也会进来更多。
这个关系在上面的标量模型里很直观:固定 时,增大 会减小 。矩阵系统的增益则有方向、单位和交叉耦合,不能把每个元素都当成 0 到 1 之间的混合比例。
如果你已知加热功率、散热规律和探头时间常数,可以进一步建立热模型。只靠加大随机游走的 去追升温,会把更多测量噪声也放进来。别为了曲线顺眼,忽略本来可以利用的物理信息。
4.2 和一阶低通有什么关系
标量更新可以改写为:
如果 最终收敛为常数,这就是一阶指数平滑的形式。所以,并不是把一个低通换成“卡尔曼”这个名字,效果就会自动升级。
区别要看你用了什么模型,如何传播不确定性,以及观测是否会缺失、噪声是否变化。单个慢变量、固定 的标量例子,本来就可能和一阶低通很接近。
5. 多状态模型:IMU 倾角与零偏估计
5.1 用陀螺仪和加速度计,估计倾角与零偏
把 IMU 固定在一块绕水平轴转动的板子上。先只考虑一个平面内的倾角 ,不做完整的三维姿态解算。
陀螺仪给的是角速度。把它积分,短时间内能跟上转动,但如果零偏 是 0.5 °/s,直接积分 20 秒就会多出约 10°。加速度计在没有明显线性加速度时,可以根据重力方向算倾角;它不用积分,却更容易受振动和外力影响。[6][7]
所以这次不只是把一个读数磨平。我们让陀螺仪负责预测倾角,再用加速度计的倾角观测纠正它,同时估计陀螺仪零偏。
约定板子只有俯仰转动,轴方向选到静止水平时 、抬起正方向时 。在这个约定下,加速度计倾角可以写成 。实际接线要先检查轴向、符号和单位;这个式子不能不看安装方向就照抄。后面的仿真直接生成这个倾角观测,不冒充原始三轴数据。[7]
状态取倾角和零偏,采样间隔为 , 表示上一段采样间隔使用的陀螺仪角速度:
状态方程、观测方程写成:
第一行展开就是 。先减零偏,再积分。负号很重要:估计的零偏越大,同一条角速度读数对应的真实转动就越小。
协方差也变成矩阵:
对角线分别描述倾角和零偏误差的方差,非对角线描述两者的相关性。加速度计没有直接测陀螺仪零偏,但它能指出积分角度偏了;滤波器通过交叉协方差,把这个误差的一部分归到零偏上。每轮把非对角线清零,就丢掉了这条修正途径。
从可观测性也能看出来:,当 时秩为 2。不过,这依赖加速度计倾角确实能作为参考;持续的线性加速度会破坏这个前提。
5.2 陀螺仪噪声和零偏漂移,怎样进 Q
这里采用一个明确的离散模型:每段使用的陀螺仪样本噪声标准差为 ,零偏在段末增加一个独立随机增量,标准差为 。两者互不相关,于是:
若角度用度,左上角单位是 °²,右下角是 (°/s)²。这里零偏在段末变化,所以同一段内不再产生额外的角度积分项。连续时间零偏随机游走的精确离散化会得到不同的矩阵,通常包含交叉项,不能把两种模型的参数直接互换。[5]
另外, 是当前采样率、带宽下的样本标准差,不是数据手册里的噪声密度;噪声密度要结合实际带宽换算。本文统一用度和秒做仿真,接收弧度单位的库函数或驱动时,需要先换算。
5.3 完整的一轮滤波
对线性模型,下面这一组公式就是实际循环。温度随机游走没有输入项;IMU 示例中 ,是进入预测的陀螺仪读数,其噪声已计入上面的 。[2][3]
预测:
收到测量后,先算创新,也就是“测到的”和“原本预计能测到的”之差:
再算增益和状态更新:
协方差的简写形式是 。代码里可以使用 Joseph 形式:
在精确运算和标准卡尔曼增益下,两者等价。Joseph 形式把协方差写成两个半正定项之和,能减少直接相减带来的数值问题,但也不意味着浮点运算从此不会出错。状态尺度差得很大、运行很久或精度要求高时,还要考虑缩放、分解求解、平方根滤波等做法。[5][10]
公式写了 ,矩阵代码通常不必显式求逆,而是解线性方程。本文每次只有一个倾角观测, 是标量,直接除即可。
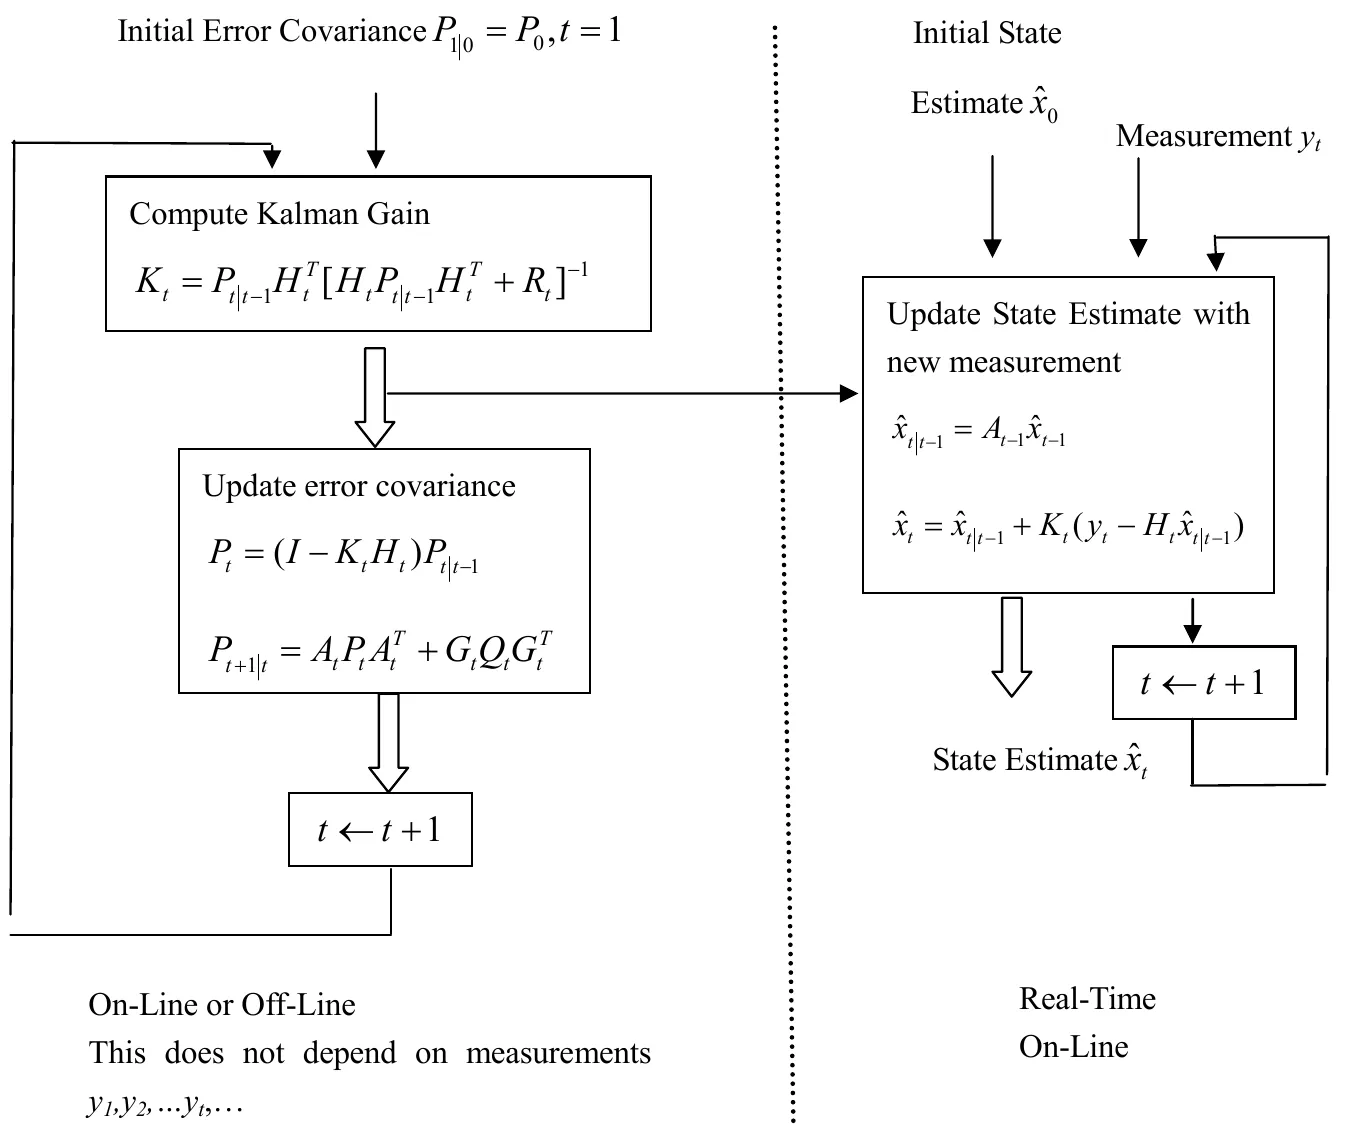
原图裁切:MIT Lecture 6,第 5 页,4.5.3 节。对于给定的模型、噪声和观测时序,协方差递推不依赖实际测量数值;加入按创新拒绝测量、自适应噪声等机制后,这个条件就变了。[2]
6. MCU 标量实现
6.1 先写一个能放进 MCU 的标量版本
这段 C99 代码对应前面的温度随机游走模型,适合慢变量的入门实验。它没有倾角和零偏两个状态,不能直接当姿态解算器。
预测与更新分开,是为了明确处理丢帧。结构体中的 p 是当前阶段的方差;调用预测后它是先验方差,更新成功后才成为后验方差。单位与输入一致,方差使用输入单位的平方。
#include <stdbool.h>#include <math.h>
typedef struct { double x; double p;} Kalman1D;
static bool kf1_valid(const Kalman1D *f){ return f && isfinite(f->x) && isfinite(f->p) && f->p >= 0.0;}
bool kf1_init(Kalman1D *f, double x0, double p0){ if (!f || !isfinite(x0) || !isfinite(p0) || p0 < 0.0) return false; f->x = x0; f->p = p0; return true;}
/* q_step: process variance for THIS prediction interval. */bool kf1_predict(Kalman1D *f, double q_step){ if (!kf1_valid(f) || !isfinite(q_step) || q_step < 0.0) return false; double p = f->p + q_step; if (!isfinite(p)) return false; f->p = p; return true;}
bool kf1_correct(Kalman1D *f, double z, double r){ if (!kf1_valid(f) || !isfinite(z) || !isfinite(r) || r <= 0.0) return false; double s = f->p + r; double innovation = z - f->x; if (!isfinite(s) || !isfinite(innovation)) return false; double k = f->p / s; double x = f->x + k * innovation; double a = 1.0 - k; double p = a * a * f->p + k * k * r; /* Joseph form */ if (!isfinite(x) || !isfinite(p)) return false; f->x = x; f->p = p; return true;}实现里要求 ,不把真实传感器当成绝对精确的测量;无效输入或计算溢出返回 false,本次调用不修改状态。更新失败时,已经完成的预测仍然保留,调用方应记录这个异常。
例如每秒获取一个摄氏温度读数,每步 ℃²、 ℃²,可以这样调用:
static Kalman1D temperature_filter;
bool temperature_start(double initial_temperature){ return kf1_init(&temperature_filter, initial_temperature, 1.0);}
bool temperature_tick(bool has_measurement, double z_celsius, double *estimate){ if (!estimate || !kf1_predict(&temperature_filter, 0.0001)) return false; bool ok = !has_measurement || kf1_correct(&temperature_filter, z_celsius, 0.01); *estimate = temperature_filter.x; return ok;}先调用 temperature_start,再每秒调用一次 temperature_tick。没有测量时传 false,此时不使用 z_celsius。如果初始温度就是第一条测量,初始化后从下一时刻开始循环,不再把同一条数据更新一遍。驱动层要先检查通信状态和器件的无效值,不能把错误码当温度传进来。
这里的 0.0001 是每步方差。如果采用连续时间随机游走、方差增长率为 的模型,才有 ;采样间隔改变时要按实际时间计算。别在不等间隔的任务里照搬一个固定常数。
7. 仿真实验、异常观测与 EKF 边界
7.1 跑一次倾角融合,再故意让加速度计观测断掉
下面的 Python 只依赖 NumPy。模拟一块缓慢摆动的板子,真实倾角为 20° 加上幅度 10° 的正弦变化。每 0.1 秒取样,陀螺仪样本噪声标准差为 0.2 °/s,初始真实零偏为 0.8 °/s,并按每步 0.01 °/s 的标准差随机变化;加速度计换算出的倾角噪声标准差为 1.5°。
这是一个单轴、加速度计主要感受重力、角度不跨越 ±180° 的简化实验。没有模拟原始三轴加速度、杆臂加速度、安装误差或温漂。初始倾角先验取安装时的名义值 20°、标准差 5°,零偏先验取 0 °/s、标准差 2 °/s;滤波器不接收仿真的真值数组。6 秒到 9 秒只停掉加速度计倾角观测,陀螺仪仍有数据,滤波器继续积分预测。真实硬件若整颗 IMU 都掉线,不能这样假定。
import numpy as np
dt = 0.1t = np.arange(201) * dtF = np.array([[1.0, -dt], [0.0, 1.0]])B = np.array([dt, 0.0])H = np.array([[1.0, 0.0]])sigma_g, sigma_b_step, sigma_z = 0.2, 0.01, 1.5Q = np.diag([(sigma_g * dt)**2, sigma_b_step**2])R = sigma_z**2
rng = np.random.default_rng(20261016)truth = np.empty((len(t), 2))truth[:, 0] = 20.0 + 10.0 * np.sin(0.6 * t)truth[0, 1] = 0.8for k in range(1, len(t)): truth[k, 1] = truth[k - 1, 1] + rng.normal(0.0, sigma_b_step)# Each gyro sample represents the average rate over [t[k], t[k+1]].gyro = np.diff(truth[:, 0]) / dt + truth[:-1, 1]gyro += rng.normal(0.0, sigma_g, len(t) - 1)z = truth[:, 0] + rng.normal(0.0, sigma_z, len(t))z[(t >= 6.0) & (t < 9.0)] = np.nan
def run_filter(measurements, gate=None): x = np.array([20.0, 0.0]) # nominal initial angle, not a measured truth input P = np.diag([25.0, 4.0]) estimates, covariances, nis = [], [], [] for k, sample in enumerate(measurements): # The prior above belongs to t=0; do not advance it before z[0]. if k > 0: x = F @ x + B * gyro[k - 1] P = F @ P @ F.T + Q score = np.nan if np.isfinite(sample): innovation = sample - (H @ x).item() S = (H @ P @ H.T).item() + R score = innovation**2 / S if gate is None or score <= gate: K = (P @ H.T) / S x = x + K[:, 0] * innovation A = np.eye(2) - K @ H P = A @ P @ A.T + R * (K @ K.T) P = 0.5 * (P + P.T) # remove tiny round-off asymmetry estimates.append(x.copy()) covariances.append(P.copy()) nis.append(score) return np.array(estimates), np.array(covariances), np.array(nis)
estimate, covariance, nis = run_filter(z)available = np.isfinite(z)raw_rmse = np.sqrt(np.mean((z[available] - truth[available, 0])**2))filtered_rmse = np.sqrt(np.mean( (estimate[available, 0] - truth[available, 0])**2))print(f"有观测时刻的倾角 RMSE:原始 {raw_rmse:.3f}°,融合 {filtered_rmse:.3f}°")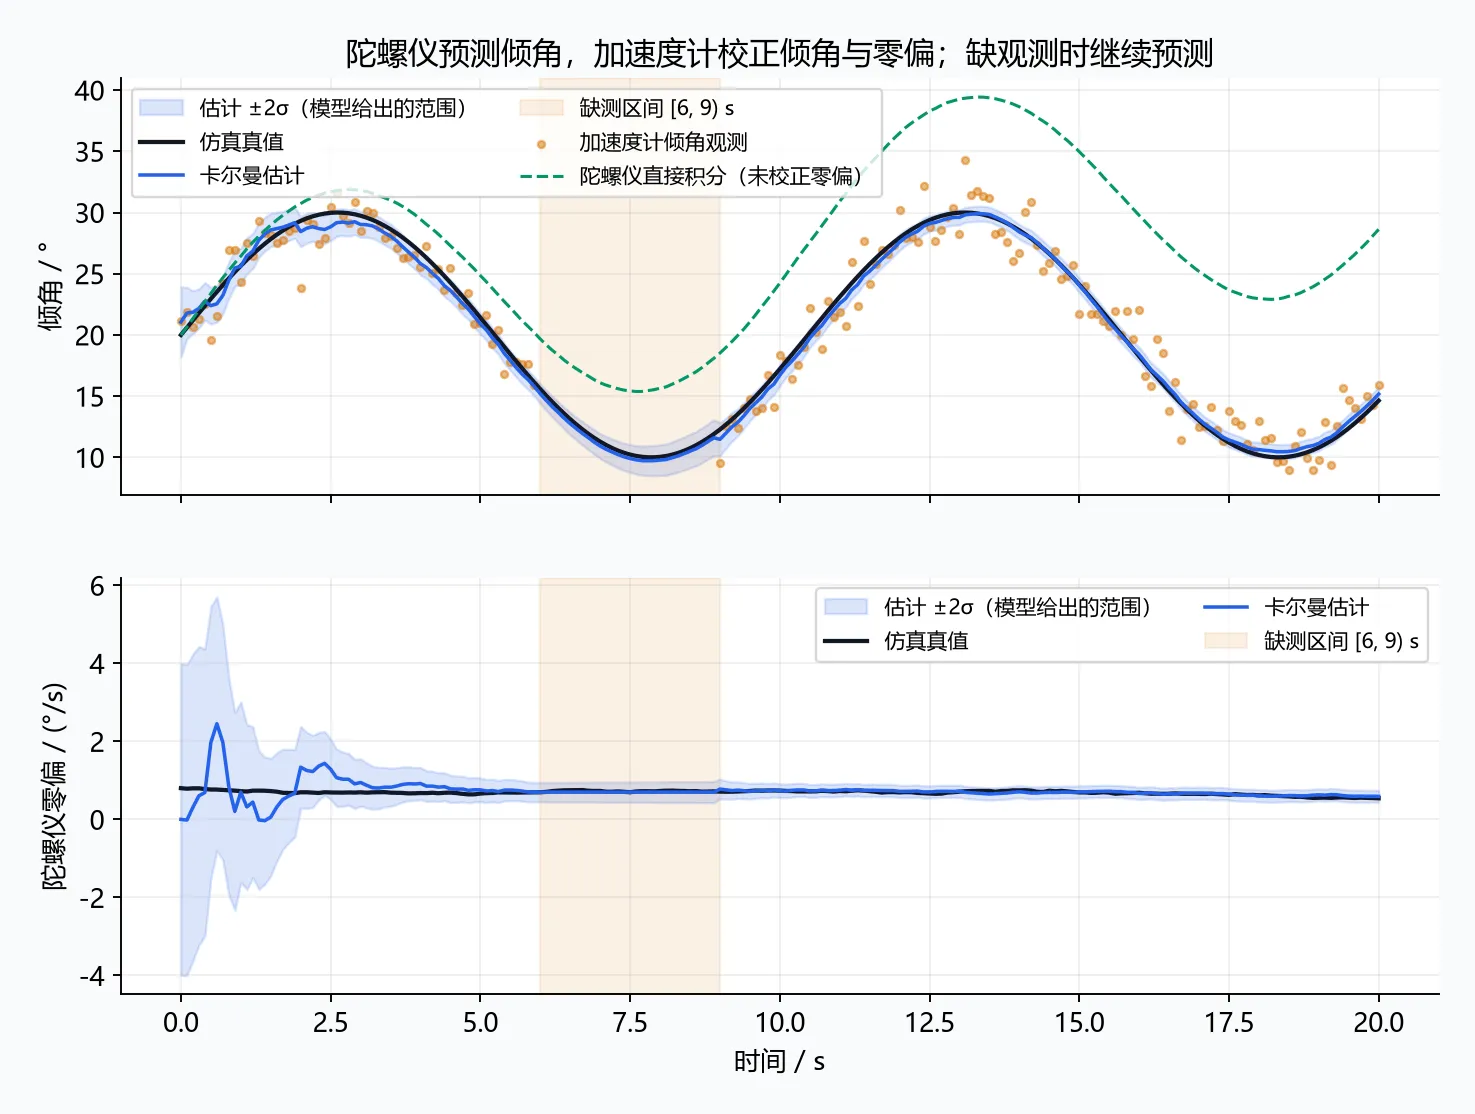
本文仿真,由上面的代码生成数据。阴影为各状态边缘分布的估计值 ±2σ;它不是整段曲线必然落入的边界,也不是两维联合置信椭圆。没有加速度计参考时,陀螺仪继续参与预测,但角度不确定性会增加。
仔细看零偏曲线:我们没有提供一条“零偏测量”,加速度计的倾角参考依然能帮助估计它。再看缺观测那一段:倾角仍随陀螺仪变化,但阴影变宽。这里停止的是校正来源,不是所有信息来源。
代码会打印同一批有观测时刻的原始倾角与融合倾角 RMSE,没有把原始读数缺失的区间混进分母。这个数字只能说明本次模拟的结果。评估真实 IMU,还得用独立的角度参考检查静止、转动、振动和恢复,不能把加速度计自己算出的倾角当成真值来证明融合有效。[8]
7.2 坏点来了,先看创新
加速度计换算出的倾角突然偏了 20°,卡尔曼滤波会自动认出它是假的吗?标准更新不会。只要传进来一条数值正常的测量,它就会按既定权重处理。
可以先观察创新 及其方差 。对本文的一维观测,归一化创新平方为:
在线性高斯、参数匹配且尚未按门限筛选的条件下,一维 NIS 服从自由度为 1 的卡方分布。 对应创新幅度超过预测标准差的 3 倍;即使模型正确,也存在约 0.27% 的单次越界概率,不是“越界就一定坏了”。[9]
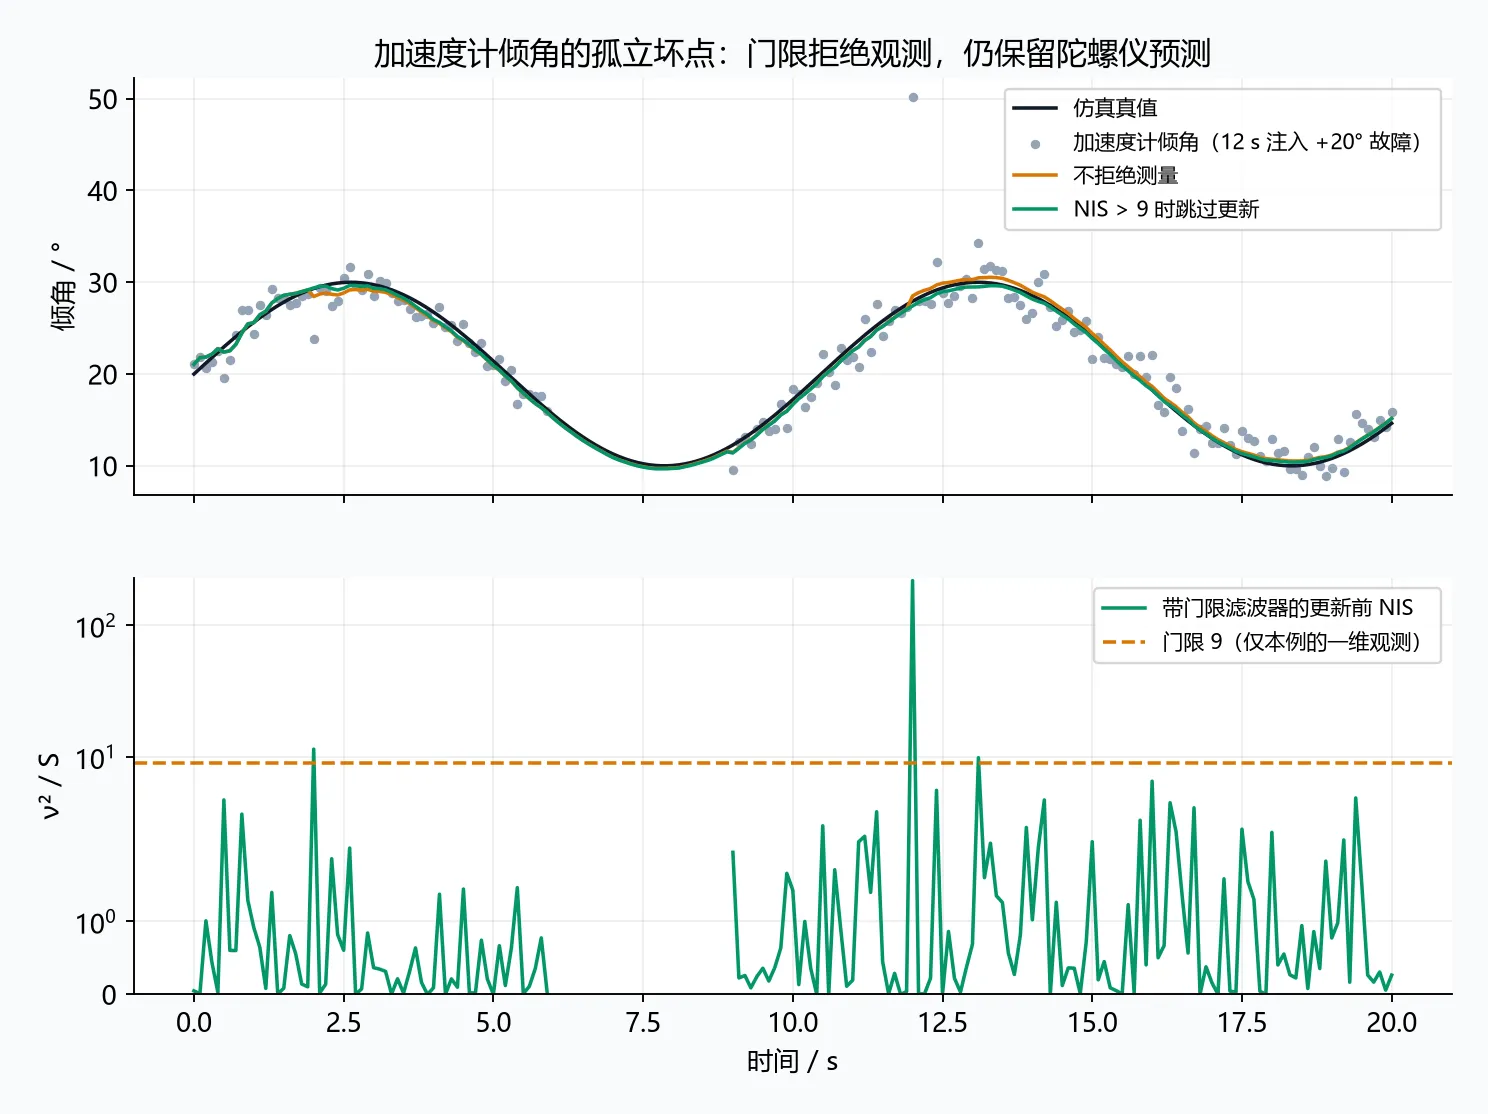
本文仿真。在前一个实验的加速度计倾角上,仅给 12 s 处额外加 20°;真实倾角和陀螺仪都不变。两组滤波器其余条件一致,绿色在 NIS > 9 时保留预测、跳过更新。下图记录的是门限判断之前的 NIS,缺测位置留空。这个坏点是人为注入的倾角故障,不是根据三轴振动数据推导出的结果。
代码里的 gate 就是这个演示开关。它能挡住这里人为注入的孤立故障,但线性加速度干扰、陀螺仪饱和、错误的时间戳、过小的 ,也会让创新变大。连续越界时先查原因,不要靠不断放宽门限把报警藏起来。
这张图里,除了 12 秒的故障,其他时刻也有越界点。这些点没有被额外注入故障,正好提醒我们:门限也会拒绝正常样本,不能把被拒绝的点一律标成传感器损坏。
多维观测使用 ,门限要按观测维数和所需概率来选。一维的 9 不能当成所有系统通用的阈值。经过拒绝测量的筛选后,也别再把保留下来的创新当作未经筛选的标准样本来做统计判断。
7.3 从单轴演示走到真实 IMU
陀螺仪的短时变化信息很好用,但零偏积分后会变成姿态漂移。加速度计能提供与重力方向有关的约束,磁力计能提供与地磁方向有关的约束。把这些信息结合起来,才有机会兼顾短时运动和长期参考。
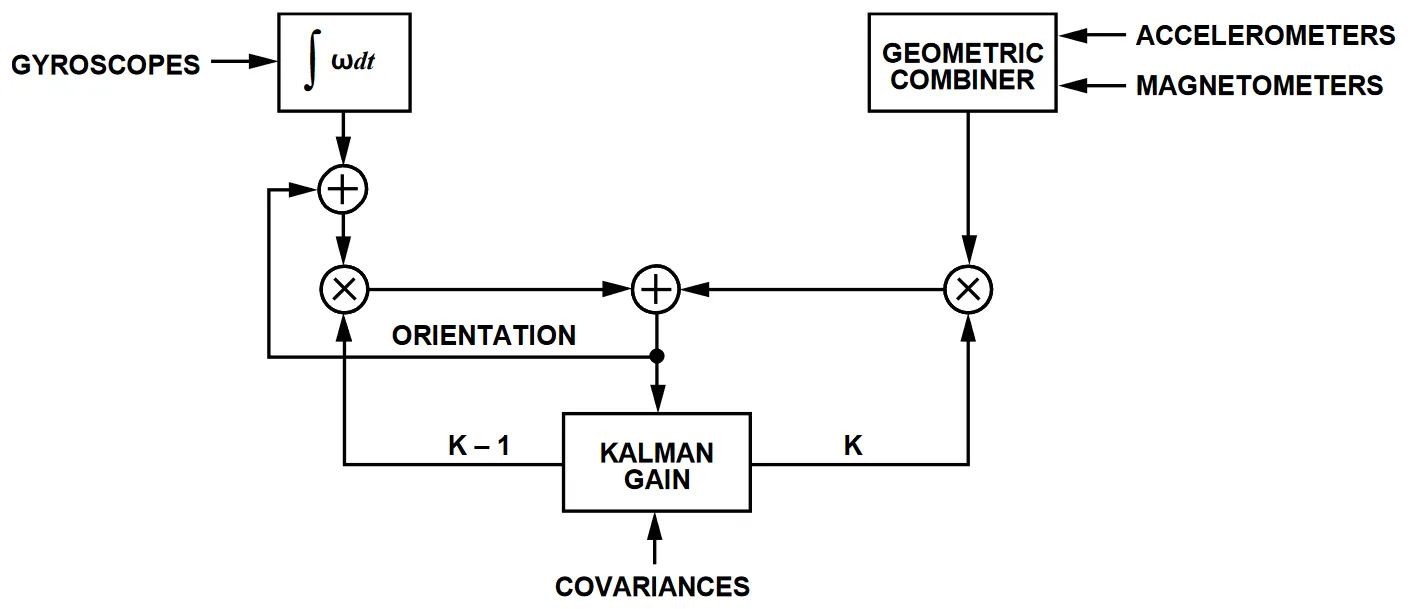
ADI AN-1157,Figure 1。使用官方原始图像,裁去空白边缘。它展示的是该器件的信号路径,不是可以逐框照抄的通用姿态 EKF 方程。[6]
但加速度计不会给每个分量贴上“这是重力”“这是手臂晃动”的标签。直接用它求倾角,通常隐含了线性加速度可忽略的条件。设备一平移或振动,这个前提就可能失效。NXP 的 AN3461 专门推导了加速度、重力与倾角的关系,值得在写姿态滤波前先看。[7]
同样,电机和附近铁件可能扰乱磁场;把它们引起的方向变化全当成真实转动,滤波公式再漂亮也救不了错误输入。
7.3.1 厂商是怎样做调参实验的
ADI 的例子先规定转动方式和安装方向,再扫描协方差参数。它不是上面的单轴 Python 模型,而是器件内部的姿态 EKF。下面把测试输入、安装方向和评价图放在一起看。[6]
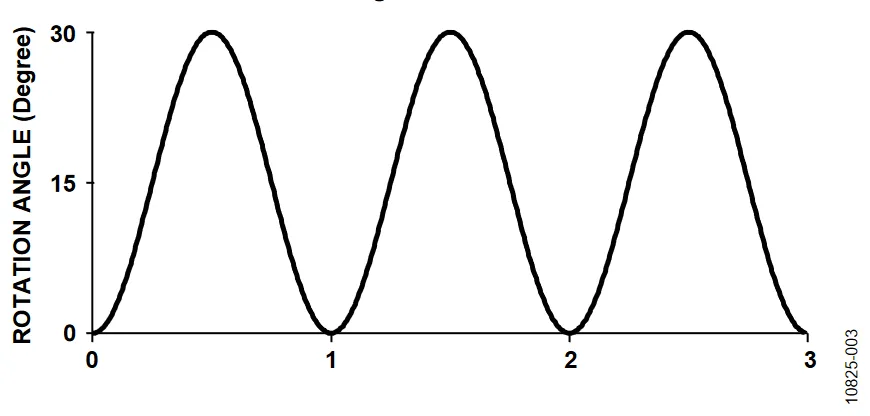
ADI AN-1157,Figure 2。规定了测试输入,才知道输出有没有跟上;这里的输入不是原始陀螺仪角速度。[6]
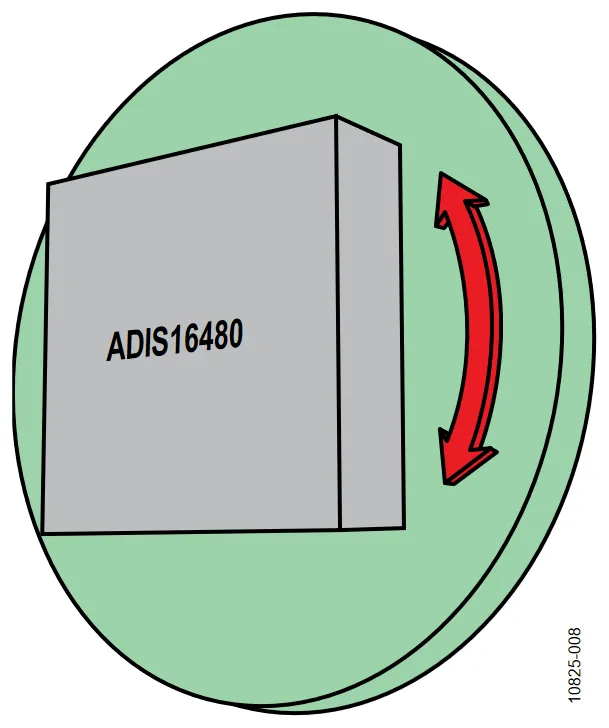
ADI AN-1157,Figure 3。这里的“水平”描述旋转轴相对地平面的方向,不等于器件某个输出轴始终水平。[6]
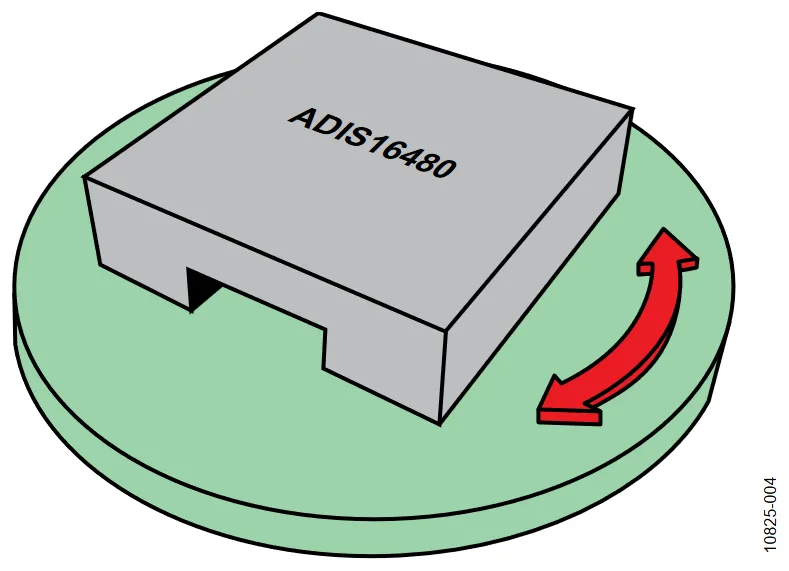
ADI AN-1157,Figure 4。旋转轴竖直时,重力在器件坐标中的投影基本不变,加速度计不能像水平轴转动时那样提供角度变化参考。这也是为什么三维姿态不能简单复制三份单轴倾角滤波器。[6]
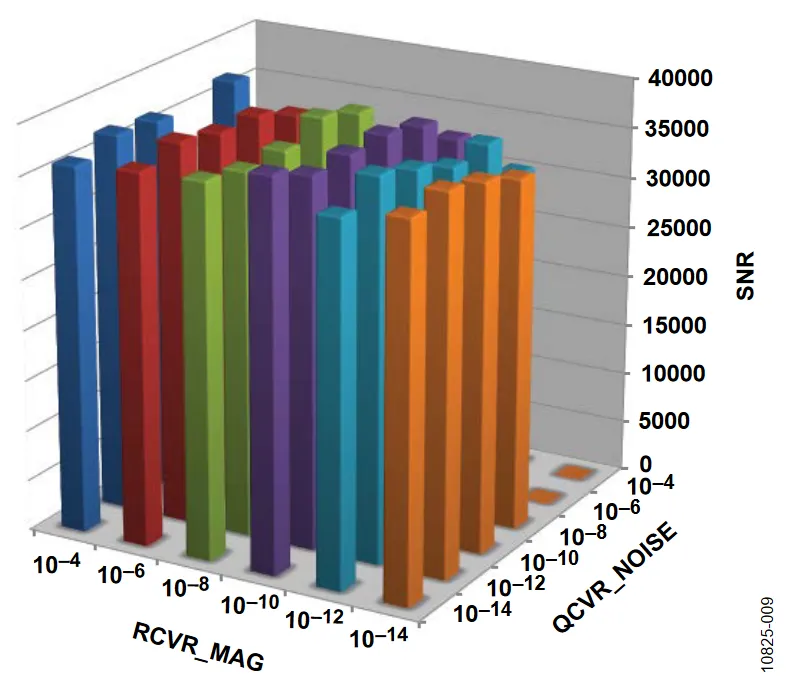
ADI AN-1157,Figure 8。1 Hz、0° 到 30° 的正弦转动;RCVR_ACC 固定为 10⁻⁸,陀螺漂移协方差固定为 10⁻¹²,其余两项扫描。纵轴为原资料定义的 SNR,不能直接改读成 dB。[6]
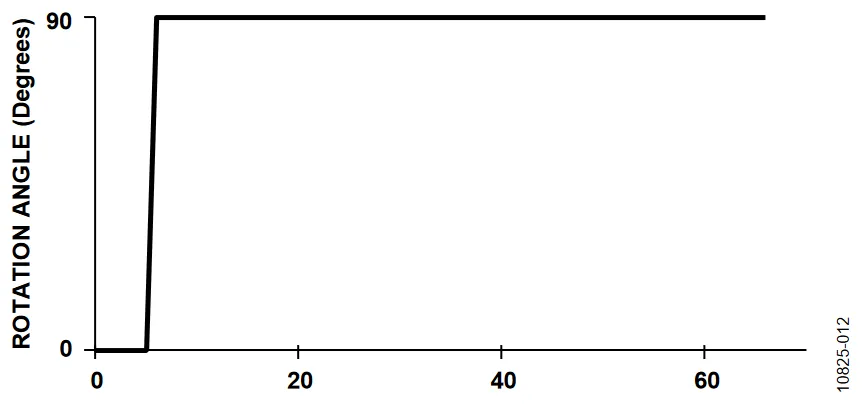
ADI AN-1157,Figure 11。观察的是转动前后两个静态读数之差,不是拿平滑程度代替角度精度。[6]
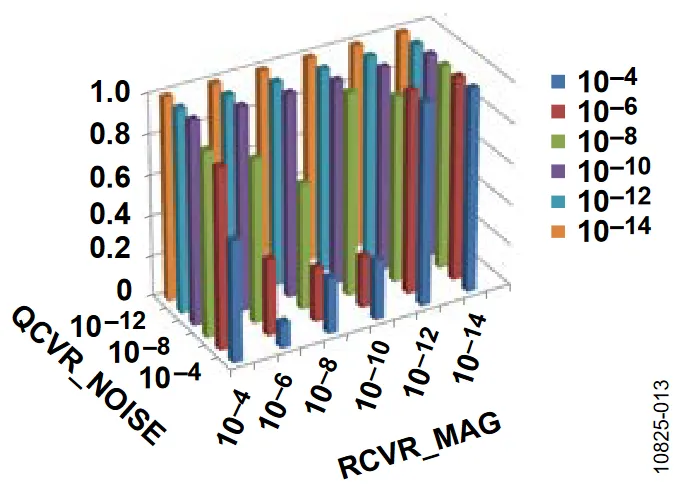
ADI AN-1157,Figure 12。比较转动 90° 前后的角度差与理想值之间的误差,图中误差显示上限为 1°,更大的误差被截顶;固定参数与上图相同,但旋转轴方向和指标不同。[6]
动态跟踪和静态角度误差要分别检查,曲线更安静也不代表角度更准。这里的寄存器名、数值与单位都属于 ADIS16480,不能抄进自己的 就算调完了。
7.4 普通 KF、EKF,差在哪一步
本文前半部分的模型和观测都是线性的,所以能直接使用 和 。对于加性噪声的非线性问题,可以写成:
EKF 仍然用非线性函数计算状态预测和预计观测,但在当前估计附近,用它们的雅可比矩阵传播协方差、计算增益。它是一阶局部近似,误差很大、初值很差或线性化不合适时可能失效。[11]
姿态还涉及坐标系、旋转表示、角度跨越 ±180°、零偏,以及四元数的约束。把三个角分别塞进三个标量滤波器,无法自动处理这些关系。例如 179° 和 −179° 实际只差 2°,直接相减却得到 −358°,创新从入口就错了。
因此,先把一维或两状态例子跑通,再去看误差状态、四元数和 IMU 预处理,会比直接复制一份长 EKF 代码更容易排查问题。[11][12]
8. 检查表、总结与参考资料
8.1 曲线不对时,按什么顺序查
不用一开始就反复改 、。先把原始测量、预测、更新结果、时间戳和创新一起记录下来,很多问题会直接露出来。
| 现象 | 先检查什么 |
|---|---|
| 温度稳定时还很抖 | 原始噪声是否变了;R 是否把标准差当成方差;Q 是否过大 |
| 升温时明显落后 | Q 是否过小;探头热惯性、采样延迟及器件自带平均滤波 |
| 估计偏了,P 却很小 | 固定偏差、错误模型、相关测量重复使用、Q/R 过于乐观 |
| 一丢帧就跑飞 | 实际 Δt 是否正确;缺测时有没有继续预测协方差;恢复时是否用了旧时间戳 |
| 倾角符号或姿态方向反了 | 坐标轴、单位、安装方向和变换顺序,尤其是度与弧度 |
| 创新一直同方向偏 | 零偏、时延或模型系统误差,单纯加大 R 可能只会把问题盖住 |
| P 不对称或出现负方差 | 更新公式、数值尺度与浮点误差;先定位原因,再考虑 Joseph 或平方根实现 |
最后还要记住“最优”这个词的条件。在线性、联合高斯且统计模型正确时,卡尔曼滤波给出条件均值和相应协方差;在线性且只规定二阶统计量等相应条件下,它仍有线性最小均方误差的意义。换成重尾噪声、未知偏差和不准确模型,就不能把这些结论原封不动搬过来。[3][12]
对实际项目,更有价值的问题是:状态是否写对,测量是否可信,丢帧和干扰后能否恢复,以及报出来的不确定性是否经得住独立数据检验。
8.2 本文小结
温度这类单变量问题,先确认状态、单位和采样周期,再用稳定数据估计 ,根据允许的跟踪滞后调整 。进入 IMU 后,状态不止一个,协方差的交叉项、坐标方向和缺测处理都不能省。卡尔曼滤波的价值不在“自动变平滑”,而在于把模型、观测和不确定性放到同一轮预测与校正中检验。
8.3 资料怎么继续读
入门先读 [1] 和 [2],跟着状态、创新和协方差各走一轮。查数值实现看 [5] 和 [10]。做 IMU 的话,把 [6]、[7] 放在手边;想补概率推导和非线性滤波,再看 [12]。[4]、[8]、[9] 属于导航与跟踪的延伸阅读,本文不使用其中的平台作例子。
- MIT / H. Harry Asada:2.160 Lecture 5,Kalman Filtering。 从观测器引出带噪声状态估计;本文的模型入口和观测器原图出自这里。课程资料页 · PDF
- MIT / H. Harry Asada:2.160 Lecture 6。 读协方差预测、增益推导和第 5 页的递推流程。PDF
- MathWorks:Linear Kalman Filters。 对照线性状态空间模型、噪声假设和预测—更新流程。官方文档
- Kyle M. Smalling、Kenneth W. Eure:A Short Tutorial on INS and GPS Integration,NASA/TM–2015-218803,2015。 延伸阅读:理解惯性传感器与外部观测怎样进入导航模型;本文不引用其中的实验图片。NASA PDF
- J. Russell Carpenter、Christopher N. D’Souza 编:Navigation Filter Best Practices,NASA/TP–2018-219822,2018。 查过程噪声离散化、Joseph 形式(式 1.41)与导航滤波数值实现。NASA PDF
- Mark Looney / Analog Devices:AN-1157,Tuning the Extended Kalman Filter in the ADIS16480。 有信号路径、实验输入、安装方向和协方差扫描结果;本文使用 Figure 1、2、3、4、8、11、12。应用笔记
- Mark Pedley / Freescale(现 NXP):AN3461,Tilt Sensing Using a Three-Axis Accelerometer,Rev. 6,2013。 先弄清楚加速度计测到了什么,再谈拿它校正姿态。官方 PDF
- MathWorks:Tuning Kalman Filter to Improve State Estimation。 用参考轨迹评价参数,注意机动段和不同数据上的验证。官方示例
- MathWorks:Analyze Motion Model Adequacy Using ADS-B Data。 看用独立航迹和 NIS 检查运动模型的示例,注意按观测维数选择卡方分布。官方示例
- Tucker McClure:How Kalman Filters Work, Part 2。 从实现角度解释协方差、Joseph 形式、求解和数值精度。作者文章
- MathWorks:extendedKalmanFilter。 对照非线性函数、雅可比、预测与校正,以及角度观测的环绕处理。官方文档
- Simo Särkkä、Lennart Svensson:Bayesian Filtering and Smoothing,第二版,2023。 系统补上贝叶斯滤波、KF、EKF、平滑及其假设。作者主页与在线书入口 · 配套代码
本文原创仿真与代码可分别通过仓库中的 scripts/generate-kalman-figures.py 和 scripts/verify-kalman-article.py 复现、检查;裁图步骤在 scripts/crop-kalman-references.py。图片来源、页码及处理范围另存于 ./kalman-filter-guide/images/SOURCES.txt。文章的许可不替代第三方图片原有许可:MIT 图按 CC BY-NC-SA 4.0 署名使用,ADI 图保留原来源与权利说明。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放