





定时器触发 ADC+DMA:搭建稳定的连续采样链路

在主循环里启动 ADC,再读取结果,适合简单的电压监测。连续记录多路传感器或计算频谱时,这种写法容易受到打印、通信和其他任务影响:数据虽然一直更新,采样间隔却不固定。
用定时器硬件触发 ADC,再由 DMA 搬运结果,可以将采样节拍与主循环分开。配置时仍有两项时间限制:一次扫描要在下次触发前完成,软件也要在 DMA 覆盖缓冲区前取走数据。
本例采用 STM32F407,按每通道 10 kS/s 采集三路电压。时钟、触发路由和缓冲长度均按这组参数计算;代码片段演示启动顺序,需配合时钟、引脚、MSP 和中断初始化使用。
1. 硬件触发与数据搬运
1.1 定时器决定何时启动
在主循环里延时后启动 ADC,采样间隔会受到打印、其他中断和分支执行时间影响。把启动函数放进定时器中断,可以改善一部分问题,但 ADC 的启动时刻仍然经过 CPU 和中断响应路径。
硬件触发让定时器事件直接送到 ADC。这样做仍然有触发同步、采集窗口和转换时延,但时序不再依赖主循环何时有空。回调函数发生在数据搬运之后,其到达时间不能代表采样边沿。
1.2 ADC 转换与 DMA 搬运如何交接
ADC 按规则序列依次处理各通道,每完成一次转换,结果进入数据寄存器;DMA 响应请求,把结果搬到递增的内存地址。循环模式下,搬运达到预设长度后从缓冲区起点继续。这条链路可以在 CPU 处理上一批数据时运行,但软件仍须在缓冲区被覆盖前完成交接。
下文用“样本”表示一次通道转换的结果,“帧”表示一次触发得到的完整三通道序列,“数据块”表示一次交给软件处理的若干帧。
1.3 本文采用的平台与路由
本文固定使用 STM32F407:TIM2 更新事件产生 TRGO,ADC1 扫描 PA0、PA1、PA2 三个外部通道,DMA2 Stream0 Channel0 循环搬运半字数据。依据是 RM0090 和 STM32CubeF4 原厂例程。换到 G4、H7 或其他厂商 MCU 时,触发路由、请求映射和缓存规则必须重新核对。
2. 从时钟计算采集与转换预算
2.1 定时器的触发频率
假设系统时钟为 168 MHz,APB1 为 42 MHz、APB2 为 84 MHz。STM32F407 在 APB1 分频不为 1 的这组条件下,TIM2 时钟为 84 MHz。TIM2 配置 PSC=83、ARR=99:
2.2 单通道时间、序列时间与搬运率
ADC 公共时钟选择 PCLK2/4,即 21 MHz。每通道设置 84 个采集周期,12 位转换再需要 12 个 ADC 周期,因此理想单通道预算为:
三通道序列约为 13.714 μs,小于 100 μs 的触发周期。这个计算包含采集和转换,触发同步等延迟还需按 RM0090 核对。84 周期能否满足输入源阻抗要求,则按采集建立分析验证。
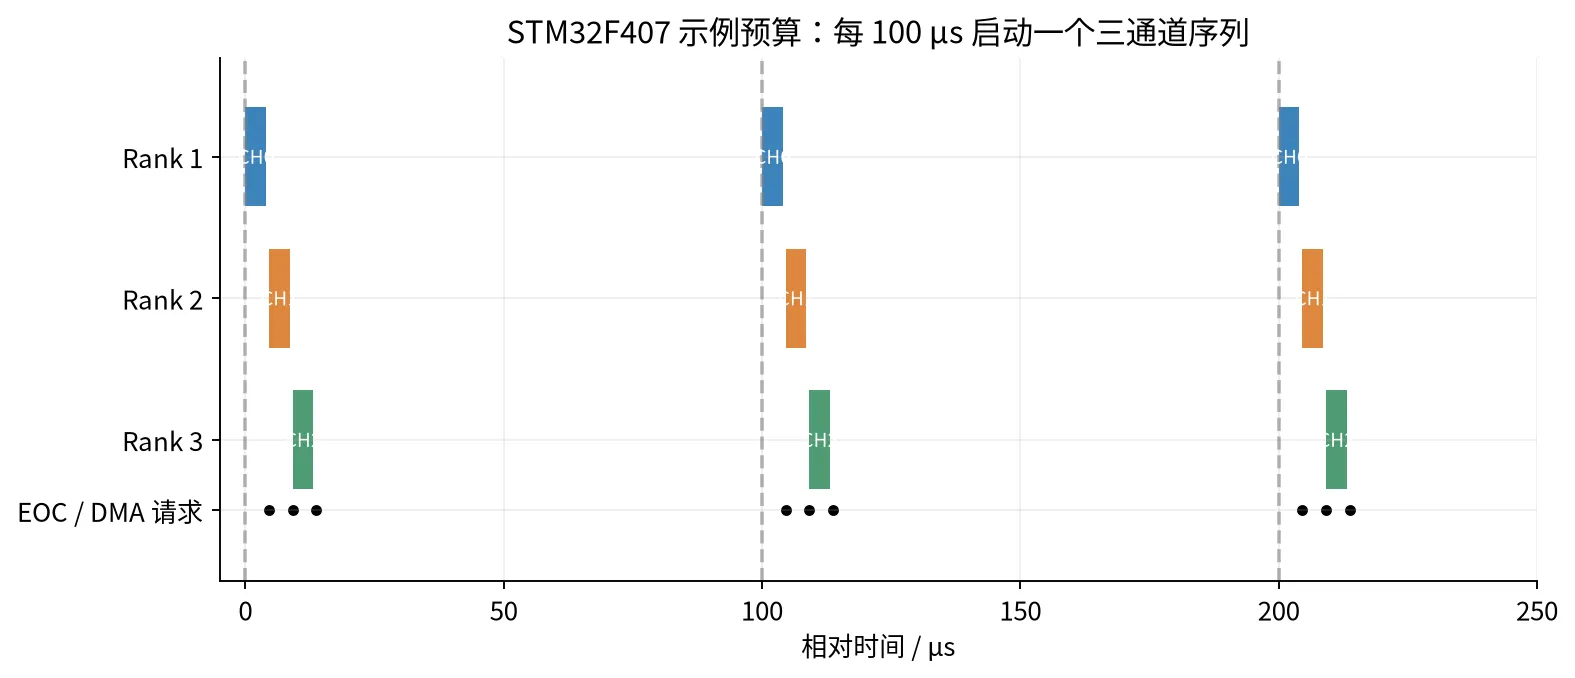
图 1:按上述时钟计算的采集、转换及 DMA 请求时序。彩色段为 84 周期采集窗口,其后为 12 周期转换;黑点为转换结束后的 DMA 请求。CPU 回调发生在此后。
每次触发得到一帧,帧里有三个样本,所以是每通道 10 kS/s、DMA 总计 30 k 个半字每秒。不要把总样本搬运率当成每个通道的采样率。
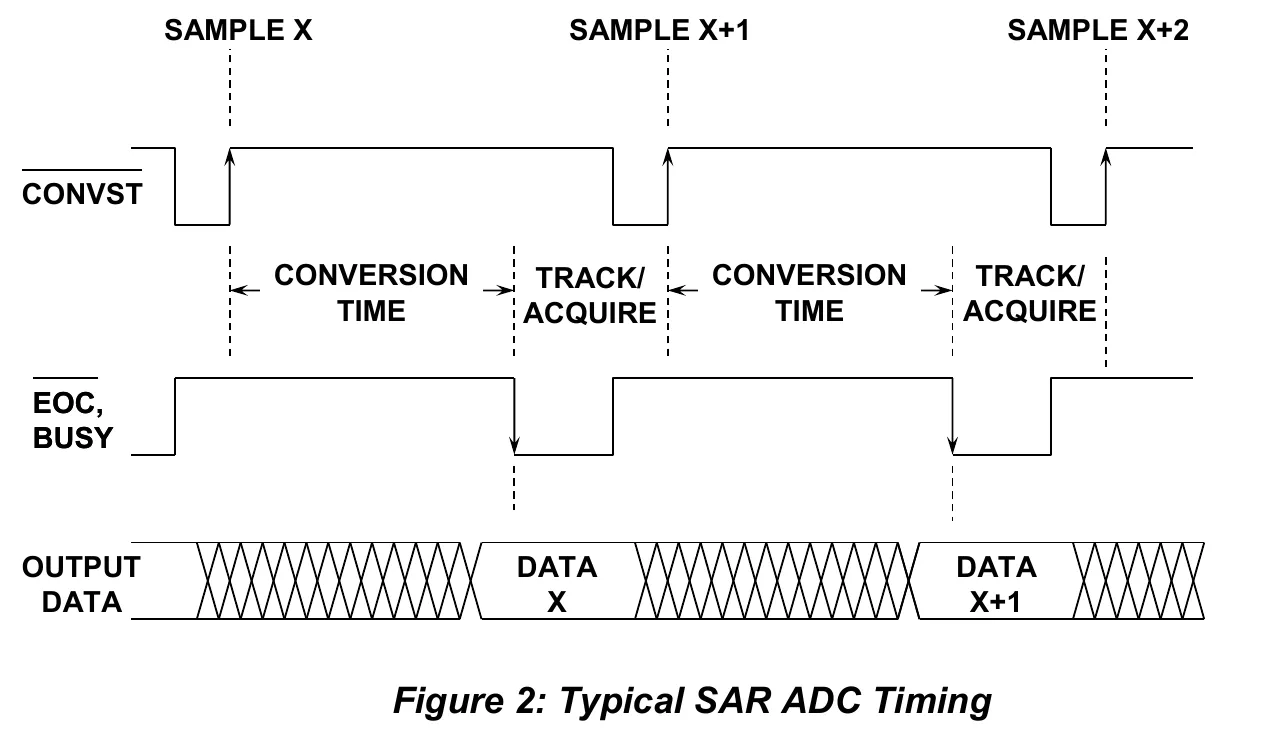
图 2:ADI MT-021,Figure 2,PDF 第 2 页,用来区分采集与转换两个阶段。该图不是 STM32F407 的总线或寄存器时序。原文
2.3 扫描偏移与随机抖动
以第一路采集窗口开始为基准,三路中相邻 rank 的采集时刻约相差 4.571 μs。若两路输入是同频 1 kHz 正弦,仅该偏移就对应 ;第一路到第三路约为 3.29°。对缓慢温度测量可能不重要,对电压电流相位、功率和快速反馈却可能不可忽略。
为数据块记录时间戳时,需要保留首帧编号、触发周期、通道顺序和各 rank 的相对位置。HT/TC 回调发生在搬运结束之后,回调时间用于诊断软件负载,块内样本的时刻则由硬件时序确定。
跟踪保持型 SAR 的标称采样时刻位于采集结束、进入保持附近,具体位置需按孔径延迟和触发同步时序修正。本例的 4 μs 采集窗口用于跟踪输入,并非对整段输入做均匀积分;若取窗口中心作为采样时刻,会引入约 2 μs 偏差。精确测相位时,还需计入模拟前端的群延迟。孔径时间与孔径延迟的定义见 ADI MT-007,第 1~2 页。
随机采样抖动会产生随输入变化率而变化的误差。对正弦输入,若 RMS 时间抖动 较小且与信号独立,抖动单项的信噪比近似为 。以 1 kHz 输入、假设的 100 ns RMS 抖动计算,约为 64 dB。固定的 rank 时差应单独作为相位误差处理。公式推导见 ADI MT-007。
3. 外设配置
3.1 触发、序列与 DMA 请求映射
可在 CubeMX 中生成基础工程,再按下表检查配置。字段名称和取值以项目采用的 STM32F4 HAL 版本为准。
| 模块 | 示例配置 | 为什么需要 |
|---|---|---|
| GPIO | PA0、PA1、PA2 为模拟模式,无上下拉 | 对应 ADC1_IN0、IN1、IN2 |
| TIM2 | PSC=83,ARR=99,TRGO=Update | 每 100 μs 发出一个触发 |
| ADC1 | 12 位,右对齐,Scan Enable,3 ranks | 每次转换按固定顺序扫描三路 |
| ADC1 | ContinuousConvMode=DISABLE | 一次外部触发只启动一个常规序列 |
| ADC1 | ExternalTrigConv=T2_TRGO,Rising | 使用硬件触发路径 |
| ADC1 | DiscontinuousConvMode=DISABLE | 不把一个序列拆成多个触发 |
| ADC1 | DMAContinuousRequests=ENABLE | 后续序列继续产生 DMA 请求 |
| ADC1 | EOCSelection=ADC_EOC_SEQ_CONV | 此处按序列定义 EOC;DMA 仍逐次搬运结果 |
| DMA2 | Stream0,Channel0,Peripheral-to-memory | 使用 ADC1 的合法请求映射 |
| DMA2 | P/M alignment=Halfword,MINC Enable | ADC_DR 低 16 位写入连续 uint16_t 数组 |
| DMA2 | FIFO Disable,P/M burst=Single | 本例采用直接模式,不混用 FIFO 门限与突发传输假设 |
| DMA2 | Circular,HT/TC/Error 中断 | 连续填充、半块交接与错误监控 |
3.2 连续转换与连续 DMA 请求的区别
ContinuousConvMode 控制 ADC 是否在序列结束后自动开始下一轮。本例将它关闭,使每轮扫描都由 TIM2 触发。DMAContinuousRequests 控制后续序列能否继续产生 DMA 请求,本例将它打开。两个字段的定义见原厂 HAL 头文件。
3.3 中断与句柄关联
DMA 初始化还包括时钟、NVIC 和 __HAL_LINKDMA() 句柄关联。DMA2_Stream0_IRQHandler() 需调用对应的 HAL DMA 中断处理函数,HT/TC 回调由这条中断路径调用。
4. 启动顺序与第一个样本
4.1 先启动 ADC 与 DMA,再启动定时器
先初始化定时器和 ADC,但保持 TIM2 停止。完成装载预分频器所需的更新、清除状态并将计数器归零;然后调用 HAL_ADC_Start_DMA() 使 ADC 与 DMA 等待触发,最后启动 TIM2。初始化中的软件更新事件也可能传播为 TRGO,最好在 ADC 尚未等待触发时完成,避免多出一帧。
enum { CHANNELS = 3, FRAMES_PER_HALF = 64 };enum { HALF_SAMPLES = CHANNELS * FRAMES_PER_HALF };enum { TOTAL_SAMPLES = 2 * HALF_SAMPLES };
/* Place in DMA-accessible SRAM, not the STM32F407 CCM region. */static uint16_t adc_dma[TOTAL_SAMPLES];
/* Call after GPIO, DMA, ADC1 and stopped TIM2 initialization. */static void start_acquisition(void){ __HAL_TIM_DISABLE(&htim2); __HAL_TIM_GENERATE_EVENT(&htim2, TIM_EVENTSOURCE_UPDATE); __HAL_TIM_CLEAR_FLAG(&htim2, TIM_FLAG_UPDATE); __HAL_TIM_SET_COUNTER(&htim2, 0);
if (HAL_ADC_Start_DMA(&hadc1, (uint32_t *)adc_dma, TOTAL_SAMPLES) != HAL_OK) { Error_Handler(); } if (HAL_TIM_Base_Start(&htim2) != HAL_OK) { Error_Handler(); }}HAL 接口参数类型是 uint32_t *,不意味着这里要将 DMA 内存数据宽度改成 32 位。实际搬运宽度由 DMA 配置决定,长度是数据项数,不是字节数。本例总长度 384 个半字,占 768 字节。
4.2 首个有效样本的模拟条件
这段代码只负责启动,ADC 的建立时间、首次有效样本、模拟前端上电稳定时间仍需按器件和板级电路处理。若使用内部温度或参考通道,还需满足其使能和采集要求。
5. 循环缓冲与处理期限
循环模式下,DMA 到达数组末尾后会从头继续写入。HT/TC 中断通知软件半区已完成,软件可读取该半区,直到 DMA 再次写回。
5.1 数组布局与半区交接
数组顺序为 CH0, CH1, CH2, CH0, CH1, CH2, ...。每半区有 64 帧、192 个半字,DMA 写完前半触发 HT,写完后半触发 TC,然后立即回到前半。前半区刚交给 CPU 时,DMA 正在写后半区;再过 6.4 ms,它就会覆盖前半区。
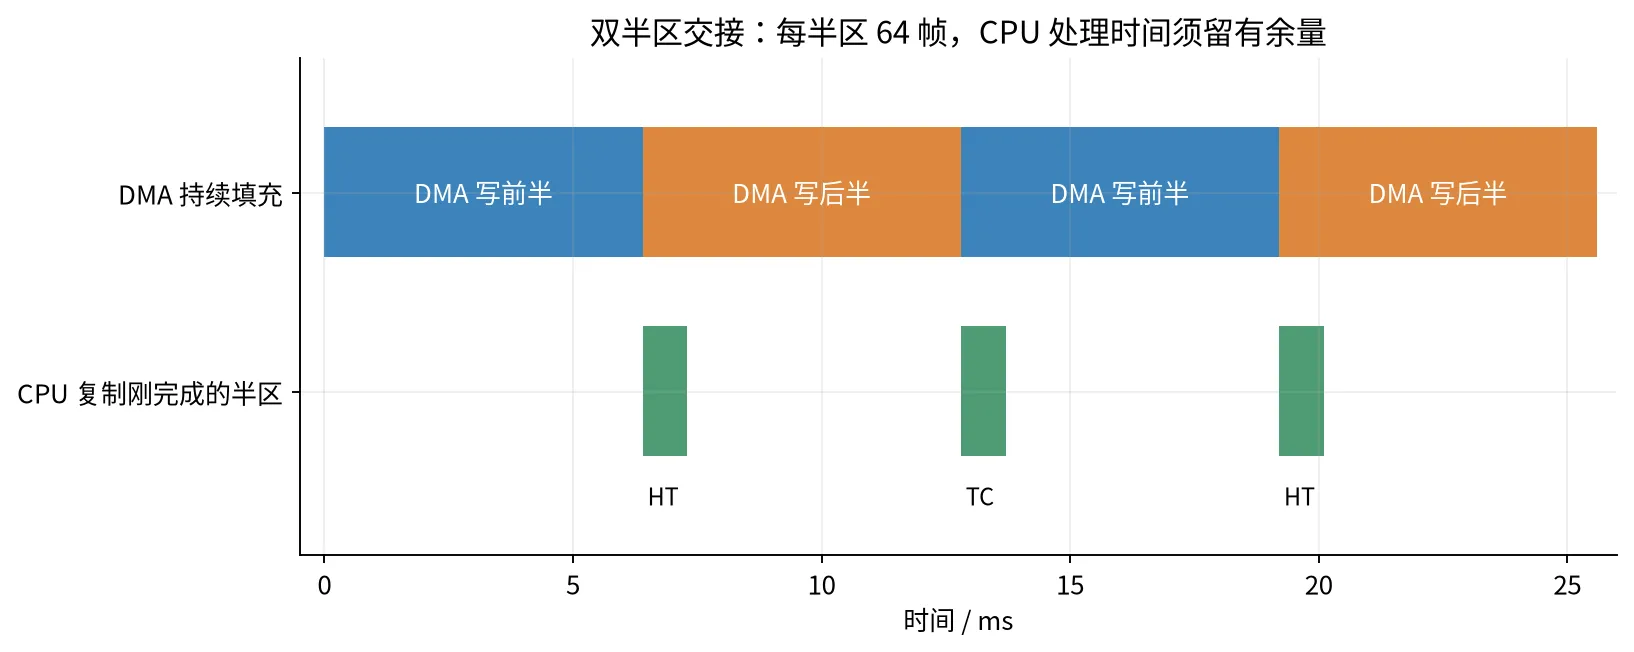
图 3:循环缓冲交接示意,绿色段为示例复制过程。处理期限需计入中断响应、抢占、复制和总线竞争。
5.2 复制、零拷贝与共享状态
一个稳妥的实现是:在 HT/TC 回调内,把刚完成的半区快速复制到软件队列拥有的空闲块,附上递增块号和状态,然后让主循环或任务处理副本。队列满时明确计数并选择丢新块或丢旧块,不能继续写一个消费者仍在使用的块。复制的最坏耗时必须小于可用窗口;若无法保证,就需要更合适的缓冲设计、较低采样率或更轻的处理负担。
也可以零拷贝地处理 DMA 半区,但必须证明消费者能在 DMA 回写前结束;排队一个指向半区的指针,并不会延长该半区的寿命。简单的 ready = 1 还会合并多个完成事件,系统落后时可能毫无察觉。用计数器或队列记录完成与消费进度,并在跨中断共享状态时采用合适的原子操作或短临界区。
volatile 限制部分编译器优化。共享计数器的多步骤读改写仍需原子操作或临界区保护,缓冲区的读写顺序也需单独约定。STM32F407 没有 Cortex-M7 的数据缓存,但 DMA 无法访问其 CCM RAM。移植到带数据缓存的 MCU 时,还需处理缓存行对齐、clean/invalidate 和 DMA 可访问的内存区域。
5.3 三种期限对应三种失效
本例至少有三个不同时间尺度。序列要在下一次触发前结束;同一序列里,ADC_DR 的结果要在下一次结果覆盖前被搬走;DMA 完成半块之后,软件又要在该半块被回写前消费或复制完。
| 约束 | 本例的理想时间尺度 | 超时后果 |
|---|---|---|
| 三路序列完成 | 13.714 μs,需小于 100 μs 触发周期并留裕量 | 忙期间触发行为须查手册,不能假定自动排队 |
| 相邻 rank 结果搬运 | 序列内部约每 4.571 μs 一个结果 | ADC overrun,与平均总带宽是否低无必然关系 |
| CPU 半区交接 | 保守按 6.4 ms 窗口安排 | 半区被覆盖,即使 ADC 与 DMA 本身未报错 |
DMA 总有效载荷仅为 ,但请求集中在每帧前约 14 μs 内,不能把 30 kS/s 的倒数当成最短请求间隔。还要区别外设端读取完成与内存端落地:若启用 FIFO,二者可能不在同一时刻。本文采用半字、单次传输的直接模式作为基线;修改为 FIFO 或 burst 后,应重新检查合法组合与错误标志。ST AN4031,第 2~3 节分别讨论仲裁和搬运延迟,不能照抄其中另一组时钟条件下的周期数作为本例保证。
5.4 软件分半与硬件双缓冲
本例使用连续数组,由 HT/TC 划分前后半区。DMA 的 DBM 硬件双缓冲则使用 M0AR、M1AR 两个地址,CT 指示当前目标,并在整块事务结束时切换。使用 DBM 时,应更新非活动目标的地址,并按 HAL 多缓冲接口设置回调和交接边界。AN4031,第 1.1.11 节
5.5 用阻塞时间估算软件队列容量
缓冲容量只能吸收短期抖动。设每 6.4 ms 产生一个块,长期平均处理时间若超过 6.4 ms,任何有限队列最终都会满;若只是偶尔被更高优先级任务阻塞,就按最大阻塞时间、处理最坏耗时和现有积压计算所需空闲块,并明确队列容量是否包含正在处理的块。
例如,假设 DMA 中断仍能及时执行复制,只有消费任务可能连续 20 ms 得不到运行机会。在任意触发相位下,这段时间最多到达 个新块,所以阻塞开始时至少需要 4 个可用的排队位置;这不包含消费者已经持有的块,也不包含后续追赶过程的余量。若每块处理最坏需 3 ms,恢复后至少要再检查这 3 ms 内是否有新块到达,以及下一次阻塞是否会在积压清空前发生。
另一项独立约束是 DMA 半区复制:假设中断响应与抢占上界为 0.25 ms,复制上界为 0.08 ms,则两者合计 0.33 ms,小于 6.4 ms 的回写窗口。上述数值是容量计算示例,必须用实际总线竞争和中断负载下的上界替换;平均 CPU 占用率无法证明这些最坏期限满足。
6. 三种“丢数据”需要分别记录
6.1 用错误计数定位失效环节
ADC overrun 指转换结果尚未被及时读取就被后续结果覆盖;DMA transfer error 指搬运过程出错;软件队列溢出则是 CPU 消费赶不上生产。三者不能只用一个“采样失败”标志。可以分别累计 OVR、DMA 错误、丢块数以及最大处理耗时,并周期性汇总输出,避免每次回调里打印。
6.2 恢复时保留数据不连续标记
发生错误后,按目标手册与 HAL 状态机停止触发、终止转换和 DMA、清标志、重置序列边界,再重新武装。是否需要丢弃重启后的首块,应按前端恢复和数据连续性需求决定。对频谱分析或控制,数据中断必须留下标记,不能把缺口前后直接拼成等间隔连续序列。
7. 采样时序与连续性测试
7.1 检查通道顺序与实际采样率
给三路输入分别施加不同的安全直流电压,先检查通道顺序和帧边界。再输入频率已知的低频正弦,核对波形周期与期望采样率;量化参考、抗混叠和测量源精度也要记录。
7.2 区分硬件节拍与软件处理时刻
在 HT/TC 回调中翻转 GPIO,可以观察块到达间隔与处理负载,但该信号包括中断延迟,不能当成 ADC 的精确采样边沿。如果需要在示波器上观察硬件节拍,可以让同一定时器的适当输出通道产生可见的标记,并明确其与 TRGO 的相位关系。测相位时还要计入触发同步延迟和三个 rank 的采样偏移。
7.3 在实际负载下验证连续性
加入通信和实际算法负载后,连续记录错误计数、块号和处理耗时最大值。重点覆盖最长临界区、高优先级中断和总线繁忙的工况,检查这些条件下是否仍满足半区交接期限。
8. 资料与复现
- ST,RM0090:重点查 ADC 规则组触发、序列时序,TIM2 TRGO,DMA2 请求映射及总线可达性。
- ST,AN4031:Using the STM32F2, STM32F4 and STM32F7 Series DMA controller:DMA 仲裁、传输与循环模式。系列相同不意味着所有产品资源相同。
- ST,STM32CubeF4 ADC_RegularConversion_DMA:原厂 ADC1 与 DMA2 Stream0 Channel0 的配置示例;其连续转换模式与本文的定时触发模式不同。
- ST,stm32f4xx_hal_adc.h、stm32f4xx_hal_adc.c:核对配置字段及错误处理行为,使用时以项目固定版本为准。
- ADI,MT-021:本文图 2 的通用 SAR 时序来源。
- ADI,MT-007:Aperture Time, Aperture Jitter, Aperture Delay Time:区别固定延迟与随机抖动,核对抖动对正弦 SNR 的限制。
图 1、3 的计算参数及生成代码在 scripts/generate-signal-chain-figures.py;图 2 的页码和裁切信息在本文 SOURCES.txt,原 PDF 保存在相邻 ADC 排错文章的 sources/,记录中包含具体相对位置。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放